AI智能体记不住昨天?claude-mem 的持久记忆机制与取舍
假设你昨天用 Claude Code 查清了一个鉴权 bug 的根因,今天开新会话,AI智能体却像从没参与过——它为什么会忘?claude-mem 试图回答的正是这个问题:它把会话中工具调用产生的观察自动捕获、用模型压缩成语义摘要,再让未来会话取回相关上下文。本文按 README 所述梳理它的机制与边界。
新会话开始后,昨天的鉴权排查为什么接不上?
先设一个贯穿场景:假设一位开发者周一用 Claude Code 排查登录接口的鉴权 bug,定位到 token 刷新逻辑,并记下复现步骤;周二开新会话继续改代码。会话结束后,模型并不保留上一轮的完整上下文,昨天的结论、试过的命令、放弃的方案都要重新讲一遍。人靠工单和笔记续接工作,AI智能体却常常从零开始。
这正是 claude-mem 要处理的问题:它不改变模型本身的记忆能力,而是在会话之外建一层可写入、可检索的记忆。按照 README 的描述,它自动捕获工具使用观察,生成语义摘要,再让未来会话取用。需要说明的是,本文讨论的是作者所述设计,未独立实测。
记忆层为什么把钩子、worker与SQLite分开
claude-mem 是公开项目,README 把它定义为面向 Claude Code 的持久记忆压缩系统。它的思路不是让模型记住一切,而是把会话中的活动变成外部记录:钩子负责在生命周期节点采集,Worker Service 是本地 HTTP API,带有 web viewer UI 与搜索端点,由 Bun 管理,SQLite 保存 sessions、observations 和 summaries,检索侧再用 mem-search 技能与 Chroma 向量库。
安装入口是 npx claude-mem install,也可在 Claude Code 的插件市场添加后安装并重启。README 特别提醒:用 npm install -g claude-mem 只安装 SDK/库,不会注册插件钩子或启动 worker 服务。这套分工决定了它的定位——一个外挂式记忆层,而不是模型内置能力。
压缩这一步:观察如何变成可检索的摘要
记忆的关键在“压缩”与“取回”两端。会话中会产生大量工具调用记录,若原样保存,既占空间也难检索;claude-mem 让模型把这些观察整理成语义摘要,并保留可引用的 ID。检索时,README 描述了一套三层工作流:先用 search 取回带 ID 的紧凑索引,再用 timeline 看时间上下文,最后用 get_observations 只为筛选后的 ID 取详情。
作者给出的 token 估算是索引每条约 50–100 tokens,详情每条约 500–1,000 tokens。它还称这种先过滤再取详情的方式可节省约 10 倍 token。这些数字来自 README,不是本文实测。压缩会丢失细节,摘要质量也取决于所用模型,因此它更像“带索引的会议纪要”,而不是逐字录像。
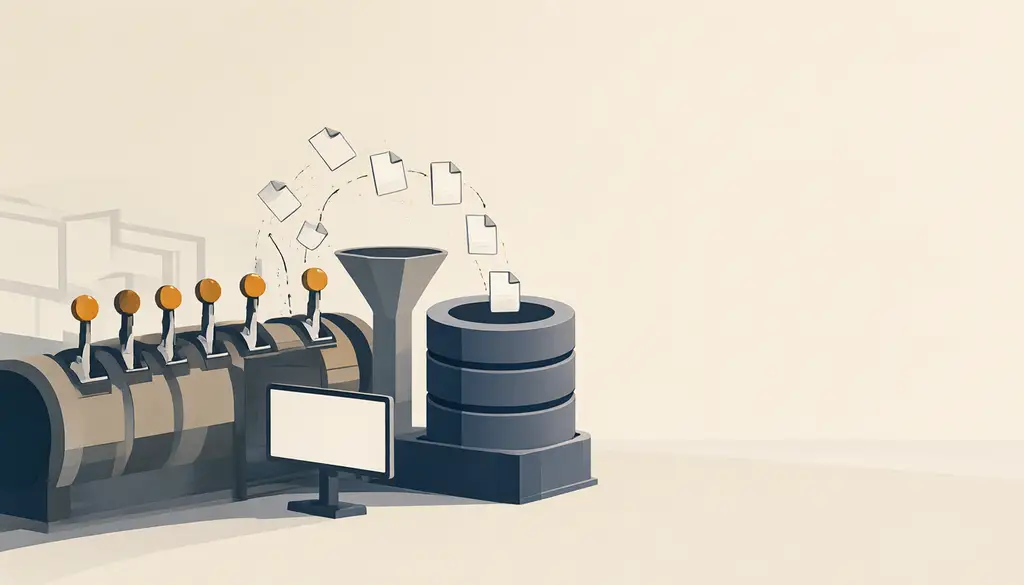
一次会话从钩子触发到写入数据库的路径
把一次会话拆开看,路径大致是:启动时注入既有记忆,用户输入时记录,工具调用前后采集观察,结束时收束并触发摘要与写库。README 列出的生命周期钩子包括 SessionStart、UserPromptSubmit、PreToolUse、PostToolUse、Stop 与 SessionEnd。
README 说每个钩子是一条 shell-free 命令,由安装器放到 PATH 上的小启动器执行。命令形如 claude-mem hook claude-code 加事件名。写入之后,worker 负责提供搜索端点与查看界面,SQLite 持久化 sessions、observations、summaries。下一次会话启动时,相关上下文再被注入。这里的工作流是作者文档的描述;实际延迟、失败重试与并发行为,本文没有测试,尚待确认。
为什么默认只注入当前harness的观察
几个默认值体现了取舍。渐进披露:先给索引,再按需取详情,并把 token 成本显示出来,避免一次性灌满上下文。来源范围:默认情况下,启动上下文只包含当前 harness 的观察。要跨工具汇总才需显式打开 CLAUDE_MEM_SESSION_START_INCLUDE_ALL_SOURCES。
隐私与开关:用 `<private>` 标签可以把敏感内容排除在存储之外。截图功能默认关闭,需要显式开启。README 说明截图保存在本地目录,只有 Cloud Sync 打开时才上传,且只有单独开启图像推理时才发给观察模型。模式与语言:CLAUDE_MEM_MODE 同时控制工作流行为与生成观察所用的语言,code--zh 为内置简体中文模式。这些设计都把“记住多少”交给用户配置。
长期项目和多入口切换时,记忆层解决什么
从 README 的定位看,它适合三类情况。第一,长期项目里的多会话续接:同一仓库反复迭代,需要知道上次改到哪、哪些方案被否。第二,跨工具的同一工作流:在 Claude Code、Codex、OpenCode 等不同入口之间切换,希望共享观察;但要注意默认只注入当前 harness,跨来源需改配置。第三,团队协作:可选的 TeamBrain 共享工作区让每人选择分享什么,个人请求与评审笔记保持分离。
反过来,一次性脚本、对隐私极度敏感且不愿配置标签的场景,收益有限。以上适用性是根据文档功能做的推断,不是实测结论。
记忆不是备份:压缩损失、登录依赖与默认开关
第一,压缩有损。观察由模型总结,细节、语气和隐含前提可能被压掉;摘要错漏会随注入影响后续判断。第二,依赖外部服务与登录。安装器会先完成设置,然后要求用户在浏览器中登录 claude-mem。也可以跳过登录改用显式 --provider 或环境变量,但不同提供方的数据路径不同,需自行确认。第三,默认不等于全量:启动上下文默认只含当前 harness,截图默认关闭,跨来源汇总需手动打开。
第四,README 称记忆搜索由 4 个 MCP 工具组成,并采用三层工作流。但正文随后只逐项列出 search、timeline、get_observations 三个工具,口径差异需要读者对照实际工具清单。以上风险来自文档阅读与设计推断,本文未独立实测。
安装前先确认哪几件事,别把插件当SDK
如果你在评估是否引入,建议先回答四个问题。一,你要解决的是“跨会话续接”还是“团队知识共享”? 前者看钩子与注入是否符合你的会话习惯,后者才需要 TeamBrain 这类共享空间。二,记忆写到哪里、由谁处理? 本地 worker 与 SQLite 是核心,云端同步与观察模型是可选项,需按数据敏感度选择。三,你是否接受摘要而非原文? 需要逐字审计的场景,应保留原始日志。四,安装方式是否正确? 认准 npx claude-mem install 或插件市场,不要只用 npm 全局安装。
README 还说明运行需要 Node.js 20.0.0 或更高版本。Bun 与 uv 缺失时会自动安装。这些判断都需结合你的数据路径确认;本文未独立实测。
claude-mem 展示了一种外挂式记忆层的思路,但是否适合你的工作流,仍需结合数据路径与摘要取舍判断。本文仅依据README资料整理,未独立实测。
参考来源
本文仅据固定版本 README 整理,未独立实测;仅作技术介绍,不构成安全审计或投资建议。
采集时间:2026-11-02T10:10:07.926Z;110090 Star 快照。相对 2026-11-01T05:08:42.540Z,实际间隔 29.02 小时净变化 1998 Star;不是自然日新增。
thedotmack/claude-mem README · 26ccf4d8a029d97fb5fb88a9f1ddd73729ad1b1a
本文基于公开媒体报道整理,仅作信息参考,不构成任何投资依据,内容以原文为准。





