AI智能体写长篇如何不忘设定?story-skills把小说变成可检查的项目
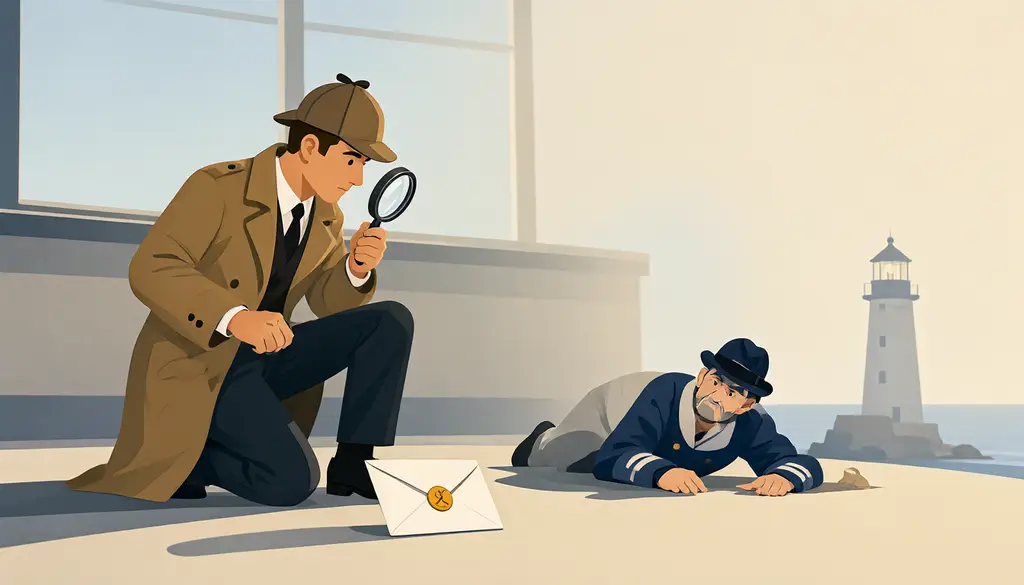
让AI智能体续写到第四章,怎样避免第二章已经死去的人又回来对话?story-skills是面向小说创作的技能与插件项目,尝试把人物、情节和正文放进共享文件格式,再用规则检查跨章节矛盾。它的重点不是再给模型一段更长的提示词,而是让故事设定成为可追踪的记录。下面以一个明确标为假设的中文悬疑小说项目贯穿说明,区分作者所述机制与仍需使用者验证的效果。
人物复活与线索穿帮,为什么不能只靠重读前文?
假设你正在写一部港口悬疑小说:守塔人在第二章死亡,侦探到第三章才发现密信,第四章却出现守塔人与侦探当面对话,解谜依据还来自尚未发现的信件。单看每段文字都可能顺畅,放到全书时间线上却互相冲突。
这类问题需要追踪“谁在何时知道什么”,不只是润色句子。README描述,场景记录与连续性状态把人物知识、物品归属、铺垫与回收保存在文件中,使这些信息能够跨会话延续。这里的“连续性”指设定与事件前后相容,而非语言是否流畅。对这个假设项目而言,首先要做的不是要求模型“更仔细”,而是把死亡、发现线索等关键事件明确记录下来,让后续写作有可核对的依据。
它把创作技能与检查工具拆开,而不是包办一切
story-skills提供共享的小说项目格式,并打包为Agent Skills以及Codex、Claude Code插件。Agent Skills可以理解为供智能体读取的任务说明与工作方法;插件则是把这些能力接入相应工具的方式。项目覆盖故事设定集、人物、世界观、情节弧线、场景与章节草稿,但这些内容不是彼此孤立的生成结果。
在假设的悬疑小说中,人物创建、章节起草和修订可以围绕同一套记录交接。配套的命令行工具负责确定性的项目维护,技能负责创作工作。确定性在这里意味着按明确规则检查已记录的数据,而不是让模型凭阅读感受判断。这样的分工把“写得有趣”和“记录是否自洽”分开,也提醒使用者:装上技能不等于已经建立了完整、准确的故事档案。
把死亡和伏笔写入元数据,矛盾才有明确检查对象
连续性引擎检查的数据包括人物死亡、铺垫与回收、未解问题、场景人物,以及物品和知识状态。这些信息放在YAML frontmatter中,即Markdown正文前部按字段组织的元数据;Markdown则是可用普通文本编辑的轻量标记格式。
回到假设场景,守塔人的死亡章节、密信的引入章节和谜底揭示章节,需要成为可比较的记录。检查器据此识别死亡后仍列入出场名单、回收早于铺垫等矛盾。README把这种反馈比作编译器报告类型错误:重点是指出具体记录哪里冲突,而非重写文学表达。它还展示了一个故意损坏的故事项目,说明文件格式合格不代表故事成立。不过,这只是作者提供的演示材料,不能据此推断所有隐含在正文中的矛盾都能被发现。
从旧稿导入到下一章,工作流围绕同一份故事记录
开始使用不一定要推倒重写。导入功能可以读取Markdown、纯文本或Word文档,并按章节标题拆分稿件。README还说明它能够导入章节文件夹,建立包含字数与登记表的项目;这些登记表相当于各类内容的目录,便于工具引用。
对假设中的已有三章稿件,可以先导入正文,再检查人物、线索与状态记录是否足够支撑后续写作。随后由技能安排章节、起草或修订,再用工具检查格式、引用和连续性;发现问题后,回到相关文件修正,而不是仅在聊天里口头承诺。
项目也提供把指定章节上下文装入词元预算的工具,词元是模型处理文本的计量单位。这有助于组织输入,但预算本身并不保证选中了所有关键信息。导入后的设定提取是否完整,同样需要作者核对。
中文名字可以保留,但引用需要稳定的标识符
这套设计把可读正文与可检查字段放在一起,也要求引用有稳定身份。README说明,中文等没有转写规则的名字需要通过 `story add --id` 指定标识符。标识符是文件和引用使用的内部名字,不必等同于角色展示给读者的姓名。
假设侦探叫“李明”,可以保留中文姓名,同时为其确定稳定标识,避免后续改名时把不同文件中的引用弄散。项目以 `story.md` 作为各技能读取的故事设定集,以各目录中的 `_index.md` 作为登记表,并要求关系双向记录。
另一项取舍是给特殊叙事留出口:README说明,回忆或死后提及可使用章节的 `mentions` 字段表达,也可记录被豁免的检查结果。规则需要正确标注叙事意图;把回忆误记为现场出场,会让本来合理的情节受到质疑。
长篇连载与多人修订,更能体现文件化管理的价值
若只写一段独立短文,维护人物表和状态字段可能比直接修改更费事;当故事跨越多章、多次会话,或需要多人审阅时,同一份文件化记录更容易成为交接基础。假设港口悬疑小说每周更新,作者就可以把“上一章留下什么问题”与“下一章准备回收什么”持续对照。
README提供的定时起草工作流会在字数、轮次和费用预算内生成下一章,并创建拉取请求供审阅。拉取请求就是把拟议修改单独提交,待审阅后再合并的协作方式;它不应被理解为成稿自动获得认可。
项目还提供审阅副本和面向具体段落的反馈入口。这样的安排适合把起草、检查、人工意见分开处理。对团队而言,价值不只是生成更快,而是有机会看清“改了哪里、影响了哪些设定”,但实际协作效果仍需验证。
检查通过不等于小说可靠,自动发布还要防止泄稿
最重要的边界是:结构化检查只能对有记录、且规则覆盖的问题作出判断。如果假设小说没有登记密信何时被发现,不能仅凭一次通过就认定人物知识没有穿帮;人物动机是否可信、悬念是否公平,也不能直接由格式与顺序检查替代。
自动化还带来稿件可见性的风险。README提醒,GitHub Pages站点默认公开,除非所用方案支持私有Pages。因此,生成审阅副本之前,应先确认仓库、发布位置和访问权限,而不是把“私人写作项目”误当成“所有输出都私密”。
此外,智能体读取哪些内容、是否发送给外部模型、相应服务如何保留数据,需要结合实际使用环境确认,不能由这份README推定。被豁免的检查结果也值得人工复查:豁免只是改变处理方式,不是证明情节没有问题。
先用一个会出错的小故事,判断维护成本是否值得
使用前可以先问三个问题:你是否愿意维护结构化设定?现有智能体能否接入相应技能?项目的检查范围是否覆盖最困扰你的矛盾?README将配套 `story` 命令行工具定位为可选工具。若目标是采用本文讨论的确定性检查流程,就还需要单独确认该工具的运行与接入条件,不能把技能安装和检查流程等同起来。
一个可行的判断方法,是拿假设小说的少量章节做小范围试用:先正确登记死亡与线索顺序,再故意制造一次人物复活、一次提前解谜,以及一次合法回忆,观察提示是否符合预期。本文并未进行这些验证。
最后还要估算修订负担:正文改动后,谁负责同步状态?误报由谁判断?原稿与工具输出如何保留?如果这些问题没有答案,新增文件可能只是另一份待维护的笔记,而不是可靠的创作基础。
story-skills值得关注的思路,是把小说从一串聊天输出变成有状态、有引用、可检查的文件项目。它试图让工具承担部分一致性核对工作,但并未因此消除作者对表达、设定和发布权限的责任。是否适合你,取决于长期追踪故事的收益能否抵消维护记录的成本。本文仅依据README资料整理,未独立实测。
参考来源
本文仅据固定版本 README 整理,未独立实测;仅作技术介绍,不构成安全审计或投资建议。
采集时间:2026-11-14T04:08:54.601Z;413 Star 快照。首次发现;暂无可用的约24小时基线,日增长未知。
danjdewhurst/story-skills README · 08fc18ac526c52b414d08dcc9a0ecb777ab767bb
本文基于公开媒体报道整理,仅作信息参考,不构成任何投资依据,内容以原文为准。





